So behalten Sie einen KI-Agenten im Griff
der Produktionscode schreibt
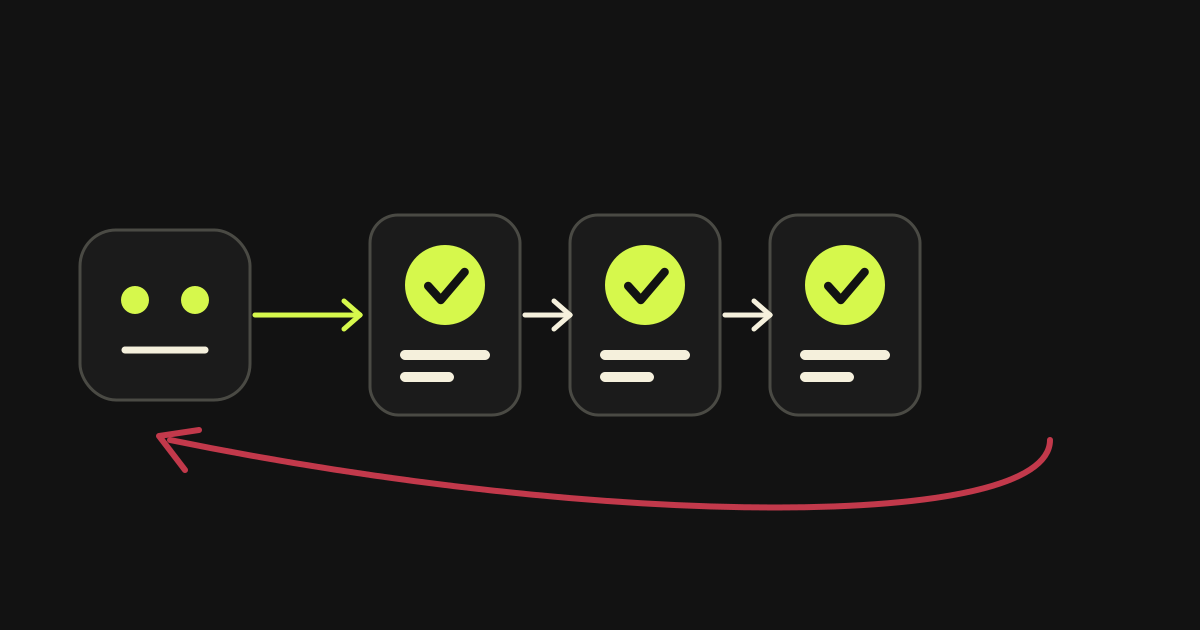
Einen KI-Agenten, der Produktionscode schreibt, hält nicht das Modell im Griff, sondern die Mechanismen drumherum. Es sind drei: Abnahmekriterien, die keinen Interpretationsspielraum lassen, die Prüfung jedes Befunds, bevor er akzeptiert wird, und ein automatisches Rollback, wenn das Deployment scheitert. Das habe ich beim Aufbau des Planner gelernt.
Auf einen Blick: KI-Agent
- Die Qualitätsgarantie sind die Mechanismen rund um das Modell, nicht das Modell selbst
- Die Tests werden vor dem Code geschrieben und legen fest, wann eine Aufgabe erledigt ist
- Jeder Befund wird am aktuellen Code geprüft, bevor er akzeptiert wird
- Ausgeliefert wird nie, solange die abschließende Prüfung rot ist
- Scheitert das Deployment, erfolgt ein automatisches Rollback
- Im Planner ist eine menschliche Freigabe nur beim Deployment nötig
Warum ist das Modell nicht die Garantie?
Ein Modell kann zehnmal richtigen Code schreiben und beim elften Mal falschen, im selben selbstsicheren Ton. Die Qualität, die Sie in der Produktion erwarten, darf nicht auf etwas beruhen, das sich nicht vorhersagen lässt. Sie beruht auf Prüfungen, die laufen, ganz gleich, was das Modell geschrieben hat.
Dieselbe Logik gilt für jedes System, das Sie nicht von innen kontrollieren. Einem Subunternehmer vertraut man nicht, weil er gut ist; man vertraut ihm, weil seine Lieferung durch eine Abnahme geht. Das Rahmenwerk zum KI-Risikomanagement der amerikanischen Normungsbehörde NIST (AI RMF 1.0) sagt im Kern dasselbe auf allgemeiner Ebene: Das Risiko von AI wird durch Prozesse rund um das System gesteuert, über seine gesamte Lebensdauer.
Im Planner habe ich das wörtlich umgesetzt. Das System nimmt eine Spezifikation entgegen und liefert eine funktionierende Anwendung. Dabei durchläuft es Architektur, Umsetzung mit Tests, die vor dem Code geschrieben werden, Qualitätsprüfung, Audit und Deployment. Keiner dieser Schritte hängt davon ab, wie „klug“ das Modell an diesem Tag gerade ist.
Das Modell selbst wechselt alle paar Monate. Die Mechanismen bleiben. Deshalb investiere ich dort.
Wie schreiben Sie Abnahmekriterien ohne Interpretationsspielraum?
Ein Abnahmekriterium lässt keinen Interpretationsspielraum, wenn eine Maschine es prüfen und mit Ja oder Nein antworten kann. „Die Seite lädt schnell“ ist ein Wunsch. „Der Formulartest läuft durch und die Seite liefert 200“ ist ein Kriterium. Die Kriterien werden vor dem Code geschrieben, und die Aufgabe ist erst erledigt, wenn alle bestanden sind.
Der Grund ist praktisch. Der Agent meldet „fertig“ mit derselben Leichtigkeit, ob er fertig ist oder nicht. Wenn er selbst beurteilt, ob er fertig ist, lassen Sie den Schüler seine eigene Klausur benoten.
Die Arbeit verlagert sich also nach vorn. Bevor die Umsetzung beginnt, hat jede Aufgabe eine Liste von Prüfungen, die grün werden müssen. Das ist TDD, auf Agenten angewandt: Die Tests sind die Spezifikation, nichts, was nachträglich dazukommt.
Was ein gutes Kriterium ausmacht
Ein gutes Kriterium hat drei Eigenschaften. Es ist maschinell prüfbar. Es betrifft das Ergebnis, nicht den Weg. Und Code, der das Falsche tut, kann es nicht erfüllen.
Das Dritte ist das Schwierigste. Lautet das Kriterium „der Test läuft durch“, hat der Agent einen bequemen Ausweg: den Test ändern. Deshalb gilt im System die Regel, dass nie ein Test, ein Typ oder eine Regel aufgeweicht wird, nur damit alles grün wird. Ist ein Kriterium falsch, wird es bewusst geändert und dokumentiert, nicht stillschweigend mitten in der Umsetzung.
| Schwaches Kriterium | Prüfbares Kriterium |
|---|---|
| Das Formular funktioniert | Das Absenden des Formulars mit gültigen Angaben liefert 2xx und zeigt eine Erfolgsmeldung |
| Die Seite ist sicher | Ein Nutzer ohne Berechtigung erhält auf der Verwaltungsroute 403 |
| Die Website ist schnell | Der erste Bildschirm verschiebt sich nach dem Laden nicht und die Bilder laden in einem modernen Format |
| Es ist nichts kaputtgegangen | Die abschließende Prüfung des Gesamtsystems läuft ohne Rot durch |
Wie prüfen Sie jeden Befund, bevor er akzeptiert wird?
Jeder Befund eines Prüf-Agenten, ob Sicherheitslücke oder Fehler, wird am aktuellen Code erneut geprüft, bevor er akzeptiert wird. Lässt er sich mit einem fehlschlagenden Test reproduzieren, ist der Befund echt und wird behoben. Lässt er sich nicht reproduzieren, wird er mit Begründung abgelehnt.
Agenten für Code-Review, Pentest oder explorative QA liefern Befunde, und ein Teil davon ist falsch: Sie beziehen sich auf Code, der sich geändert hat, missverstehen ein Pattern oder schlagen etwas vor, das anderswo schon abgedeckt ist. Wenn Sie alle übernehmen, füllen Sie das Projekt mit unnötigen Änderungen und bauen manchmal neue Fehler ein.
Im Agent Studio laufen spezialisierte Agenten parallel, jeder in seinem Bereich: Code-Review, Sicherheit, Pentest, QA, UX, SEO/AEO. Danach fragt ein eigener Prüfschritt nicht „klingt das plausibel?“, sondern „kann ich es beweisen?“. Der Befund wird entweder durch einen fehlschlagenden Test belegt oder durch eine aktive Prüfung widerlegt.
Die Antwort wird zur Regel
Was einmal beantwortet ist, wird zur Regel. Schlägt ein Agent etwas vor und die Prüfung lehnt es ab, wird die Ablehnung festgehalten, damit es in der nächsten Runde nicht erneut vorgeschlagen wird. Ohne das kehren dieselben falschen Vorschläge in jedem Zyklus wieder und kosten Zeit.
Die Prüfung hält den Code noch auf eine zweite Weise stabil: Jeder Befund wird gegen den aktuellen Code geprüft, nicht gegen ein altes Abbild davon. Ein Befund, der vor drei Änderungen noch stimmte, kann längst gelöst sein.
Was leistet das automatische Rollback, wenn das Deployment scheitert?
Scheitert das Deployment, stellt das automatische Rollback die vorherige funktionierende Version wieder her, ohne auf einen Menschen zu warten. Der Dienst kehrt in einen bekannten guten Zustand zurück, und der Fehler wird festgehalten, damit er in Ruhe behoben werden kann, nicht unter Druck. So beschränkt sich der Schaden auf die Zeit, die das System braucht, um den Fehler zu bemerken.
Das Rollback ist die letzte Verteidigungslinie und darf deshalb von niemandem abhängen. Tests und Prüfung senken die Wahrscheinlichkeit, dass schlechter Code in die Produktion gelangt. Auf null bringen sie sie nicht. Eine Produktionsumgebung hat immer etwas, das die Testumgebung nicht hat: echte Daten, echte Last, eine abweichende Einstellung.
Zwei Dinge sorgen dafür, dass das Rollback funktioniert. Erstens bleibt die vorherige Version verfügbar, bis die neue sich als gut erwiesen hat. Zweitens trifft die Entscheidung ein Health-Check nach dem Deployment, nicht die Laune von irgendjemandem. Außerdem wird nie ausgeliefert, solange die abschließende Prüfung rot ist: Scheitert vor dem Deployment etwas, startet das Deployment nicht.
Wie menschlich bleibt das System?
Im Planner wird der Mensch an zwei Stellen gebraucht: in den Feedback-Runden, in denen der Inhaber aufschreibt, was er möchte, und das System es umsetzt und erneut zeigt, und bei der Freigabe des Deployments. Alle Zwischenschritte laufen, ohne auf ihn zu warten, und die Entscheidung, was in die Produktion geht, bleibt immer bei einem Menschen.
Die Freigabe beim Deployment ist Absicht. Dort verlässt eine falsche Entscheidung das Labor und trifft echte Nutzer, und dort will ich ein Paar menschlicher Augen. Überall sonst übernehmen Mechanismen die Kontrolle, die nicht ermüden und sich nicht langweilen.
Das System hält außerdem bei jedem Schritt seinen Zustand fest. Bricht der Ablauf ab, macht es dort weiter, wo es aufgehört hat, und beginnt nicht von vorn. Auf einem Rechner läuft jeweils nur ein Projekt, mit Sperre sowie Grenzen für Speicher und Last, damit zwei Aufgaben nicht kollidieren.
Wie fangen Sie an, dieselben Mechanismen aufzubauen?
Sie beginnen mit dem kleinsten Baustein, der Wert hat: einem maschinell prüfbaren Abnahmekriterium für jede Aufgabe. Dann kommt die Prüfung der Befunde dazu, und als Letztes das automatische Rollback. Jeder Schritt funktioniert auch allein, Sie müssen also nicht das ganze System aufbauen, bevor Sie einen Nutzen sehen.
Diese Schritte in der Reihenfolge:
- Schreiben Sie für jede Aufgabe die Abnahmekriterien als Prüfungen, die bestehen oder scheitern, bevor der Agent startet.
- Verbieten Sie das Aufweichen eines Tests, Typs oder einer Regel, nur damit alles grün wird. Die Änderung eines Kriteriums geschieht offen.
- Verlangen Sie für jeden Befund, den ein Agent liefert, einen Beleg am aktuellen Code: einen fehlschlagenden Test oder eine dokumentierte Widerlegung.
- Führen Sie Protokoll über die abgelehnten Befunde, damit sie nicht wiederkehren.
- Koppeln Sie das Deployment an einen Health-Check und die automatische Wiederherstellung der vorherigen Version.
- Lassen Sie eine menschliche Freigabe dort, wo die Änderung echte Nutzer berührt.
Wenn Sie so etwas in Ihrem Team brauchen, können Sie mit mir sprechen. Den größeren Rahmen meiner Arbeit mit KI-Agenten finden Sie auf der Startseite, und ein verwandtes Beispiel für ein System, das selbst entscheidet, ist das Blockieren von Scannern anhand ihres Verhaltens.
Häufige Fragen: KI-Agent
Nein. Ein besseres Modell macht weniger Fehler, aber nicht null, und Sie können nicht im Voraus wissen, welche es sein werden. Die Prüfungen laufen unabhängig vom Modell und bleiben deshalb auch dann nützlich, wenn das Modell besser wird.
Es heißt, dass eine Maschine es prüfen und ohne Urteil mit Ja oder Nein antworten kann. „Der Test läuft durch und der Endpoint liefert 200“ ist so ein Kriterium. „Die Funktion arbeitet korrekt“ ist es nicht.
Weil ein Teil der Befunde falsch ist: Sie betreffen Code, der sich geändert hat, missverstehen ein Pattern oder sind schon abgedeckt. Übernehmen Sie alle Befunde, fügen Sie grundlos Änderungen hinzu. Die Prüfung am aktuellen Code behält nur, was sich beweisen lässt.
Ja, beim Deployment. Das Rollback begrenzt den Schaden, wenn etwas schiefgeht, entscheidet aber nicht, ob eine Änderung zu den Nutzern darf. Diese Entscheidung bleibt beim Menschen.
Quellen: KI-Agent
Zuletzt aktualisiert: