Scanner am Verhalten erkennen und blockieren, nicht an der Liste
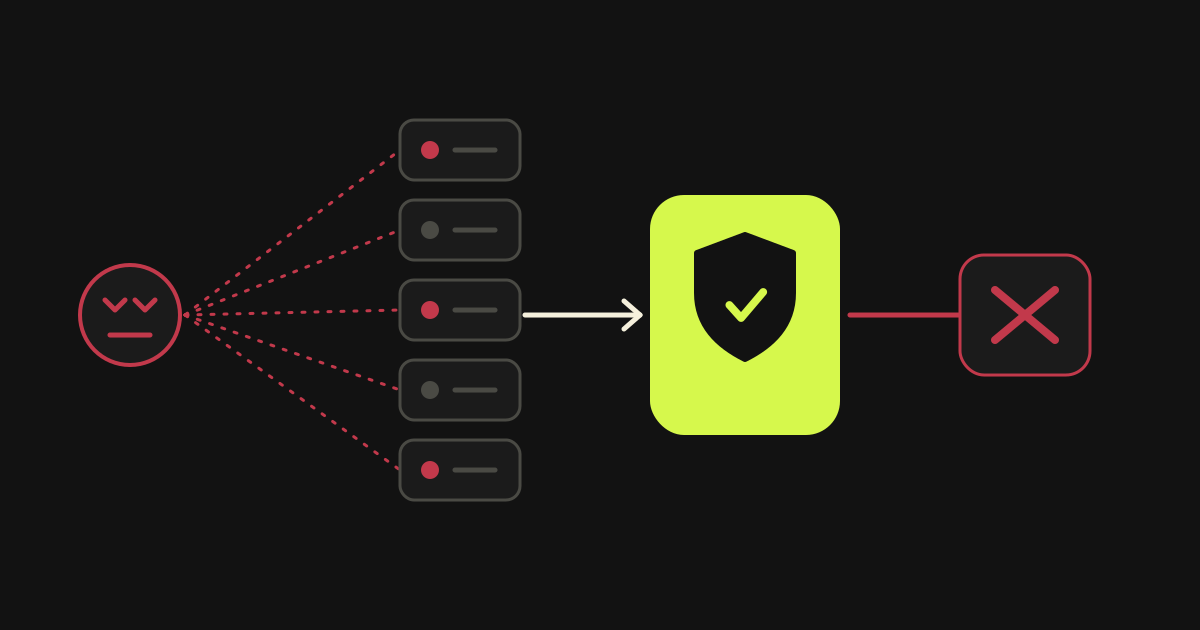
Ein bösartiger Scanner lässt sich besser an dem erkennen, was er tut, als an dem, wer er ist. Oberhalb von AWS WAF habe ich ein Serverless-System mit Lambda, EventBridge und DynamoDB geschrieben, das das Muster der Anfragen liest, den Scanner herausfiltert und ihn von selbst blockiert.
Auf einen Blick: bösartiger Scanner
- Listen bekannter bösartiger Adressen hinken neuen Adressen immer hinterher
- Ein Scanner unterscheidet sich durch das Muster seiner Anfragen und nicht durch seine Identität
- Das System nutzt AWS WAF, Lambda, EventBridge und DynamoDB
- Die Blockierung geschieht automatisch, ohne dass ein Mensch eingreift
- Das System lief in der Produktivinfrastruktur einer Gesundheitsplattform in den USA
Warum hinken Listen bösartiger Adressen immer hinterher?
Eine Liste bekannter bösartiger Adressen beschreibt das Gestern. Eine Adresse kommt erst auf die Liste, nachdem jemand sie bereits bei einem Angriff gesehen hat, und der Angreifer wechselt die Adresse mit minimalen Kosten. So ist die Liste immer einen Tag hinter demjenigen, der sie am wenigsten beachtet.
Dazu kommt ein zweites, subtileres Problem. Listen kennen Ihre Website nicht. Eine Adresse, die in einer anderen Umgebung Lärm gemacht hat, sagt Ihnen nichts, und eine saubere Adresse kann genau in diesem Moment Ihre Seiten absuchen.
Der Scanner hat jedoch etwas, das sich nicht so leicht ändern lässt: sein Verhalten. Er sucht Pfade, die es auf Ihrer Website nicht gibt, probiert Admin-Seiten anderer Systeme aus, fordert Konfigurationsdateien an. Ein normaler Besucher tut das nie. Dieser Unterschied ist der Grund, warum es sich lohnt, auf das Verhalten zu achten.
Auf der Gesundheitsplattform in den USA, auf der ich die Infrastruktur allein aufgebaut habe, reichte der Schutz von der Stange nicht aus. Ich wollte ein System, das lernt, wer an die Tür klopft.
Woran erkennt man das Muster eines Scanners?
Das Muster eines Scanners zeigt sich in der Abfolge der Anfragen, nicht in einer einzelnen Anfrage. Viele Anfragen an nicht existierende Pfade, in kurzer Zeit, von derselben Quelle, deuten auf die Suche nach Schwachstellen hin und nicht auf die Nutzung der Anwendung. Deshalb muss die Entscheidung auf dem Gesamtverhalten der Quelle beruhen.
Eine einzelne Anfrage an eine unbekannte Seite ist harmlos: Der Nutzer hat sich vertippt. Dieselbe Anfrage zehnmal in wenigen Sekunden, jedes Mal an einen anderen bekannten „verwundbaren“ Pfad, ist etwas anderes. Das Signal ist die Wiederholung und die Vielfalt zusammen.
Darum wird die Entscheidung nicht pro Anfrage getroffen, sondern pro Quelle und pro Zeitfenster. Das System zählt, wie viele solcher Anfragen es gab und von welcher Art, und nur wenn die Summe einen Schwellenwert überschreitet, gilt die Adresse als Scanner.
| Worauf Sie achten | Normaler Besucher | Scanner |
|---|---|---|
| Angeforderte Pfade | Die, die es auf der Website gibt | Viele, die es nicht gibt |
| Reihenfolge der Anfragen | Folgt Links | Arbeitet eine Liste bekannter Stellen ab |
| Wiederholung in kurzer Zeit | Selten | Häufig |
| Reaktion auf Fehler | Hört auf oder wechselt die Seite | Macht mit dem nächsten Versuch weiter |
Was deckt die Ratenbegrenzung von AWS WAF nicht ab?
Die Ratenbegrenzung von AWS WAF misst, wie schnell Anfragen eintreffen, nicht, was sie anfordern. Ein langsamer Scanner unterhalb des Limits wird nicht gebremst, während ein normaler Nutzer hinter einer gemeinsam genutzten Adresse es überschreiten kann. Das Verhalten schließt diese Lücke.
Das WAF bringt mit den Rate-based-Regeln bereits einen Mechanismus mit ähnlicher Logik mit. Sie zählen Anfragen, die sehr schnell eintreffen, und begrenzen die Gruppen, die den Schwellenwert überschreiten, mit einem Auswertungsfenster und einem Limit, die Sie selbst festlegen. Ob die Anfragen aber an Pfade gehen, die ein normaler Besucher nie anfordern würde, weiß es nicht. Hier setzt mein System an, als zusätzliche Schicht und nicht als Ersatz.
Wie funktioniert das System mit Lambda, EventBridge und DynamoDB?
Das System hat vier Bausteine. Das WAF sieht jede Anfrage. Eine Lambda bewertet das Verhalten der Quelle. DynamoDB hält den Zustand jeder Quelle. EventBridge verbindet alles und liefert den Takt. Überschreitet die Quelle den Schwellenwert, schließt ein Befehl an das WAF sie aus.
Dass ich Serverless gewählt habe, hat einen praktischen Grund. Ein Abwehrsystem muss immer aktiv sein, darf nicht von einem Server abhängen, der ausfallen kann, und sollte nach Nutzung bezahlt werden. Die Lambda läuft nur, wenn es etwas zu tun gibt. DynamoDB liefert schnelles Lesen und Schreiben des Zustands pro Quelle, ohne dass Sie eine Datenbank aufsetzen. EventBridge übernimmt die Verklebung ohne eigenen Queue-Code.
Die Schritte des Ablaufs
Der Ablauf sieht in einfachen Worten so aus:
- AWS WAF prüft jede Anfrage an die Anwendung und erzeugt ein Protokoll.
- Die Protokolldaten gelangen zu einer Lambda, die das Verhalten der Quelle bewertet.
- DynamoDB speichert die Historie und den Score jeder Quelle für das Zeitfenster.
- EventBridge löst die Auswertung und die nötigen Aktionen aus, ohne dass ich einen eigenen Planungsmechanismus brauche.
- Überschreitet eine Quelle den Schwellenwert, wird ihre Adresse zu den Regeln des WAF hinzugefügt und der Scanner blockiert.
- Die Blockierung wird protokolliert, damit sichtbar ist, was passiert ist und warum.
Was verhindert, dass normale Besucher ausgesperrt werden
Das größte Risiko eines solchen Systems sind falsch positive Treffer: einen echten Kunden auszusperren. Deshalb beruht die Entscheidung auf einem Muster und nicht auf einer einzelnen Anfrage, und die Blockierung ist kontrollierbar und umkehrbar. Eine blockierte Adresse lässt sich wieder freigeben.
Das System ersetzt die übrigen Schichten nicht. Es arbeitete zusammen mit den übrigen Werkzeugen der Infrastruktur: GuardDuty zur Erkennung von Bedrohungen, CloudTrail für die Spur jeder Aktion, Security Hub zur Bündelung von Befunden und CloudWatch für die tägliche Überwachung. Die Regel lautet: Jede Schicht deckt ab, was die andere nicht sieht.
Wenn Sie ein ähnliches Vorgehen für Ihre eigene Infrastruktur interessiert, schreiben Sie mir. Das größere Bild der Infrastruktur finden Sie im AWS-Abschnitt der Startseite, und ein weiteres Beispiel für ein System, das selbst entscheidet, diesmal für Code, ist die Kontrolle eines KI-Agenten in Produktion.
Worauf sollten Sie achten, wenn Sie etwas Ähnliches bauen?
Auf drei Dinge: mit Protokollieren beginnen und nicht mit Blockieren, einen Weg haben, eine Entscheidung rückgängig zu machen, und ausnehmen, was Ihnen selbst gehört. Bevor Sie irgendetwas blockieren, beobachten Sie eine Zeit lang, was Ihre Regel blockieren würde, und korrigieren Sie sie, bevor sie echte Besucher trifft.
Zuerst zu protokollieren ist der billigste Weg, die Grenzen zu finden. Hätte Ihre Regel Ihre eigene Überwachungsprüfung oder einen Partner ausgesperrt, sehen Sie das, bevor es passiert.
Das Rückgängigmachen ist das Zweite. Ein System, das automatisch blockiert und keinen Weg zurück hat, ist ein Risiko für das Unternehmen. Die Adresse muss aus der Blockierung herauskommen können, und jede Blockierung braucht einen sichtbaren Grund.
Das Dritte sind die Ausnahmen: Büroadressen, Überwachungswerkzeuge, Dienste, die Ihre API aufrufen. Sie tragen sie ausdrücklich ein, um sich nicht auf den Zufall zu verlassen.
Behalten Sie außerdem eine Möglichkeit, zu sehen, warum eine Quelle blockiert wurde. Wenn die Regel sich nicht erklären lässt, können Sie ihr weder vertrauen noch sie korrigieren, wenn sie sich irrt. Der Grund, der zusammen mit der Blockierung protokolliert wird, macht das System kontrollierbar und nicht bloß automatisch.
Häufige Fragen: bösartiger Scanner
Ein automatisiertes Programm, das massenhaft Adressen und Pfade einer Website auf bekannte Schwachstellen hin testet: Admin-Seiten, Konfigurationsdateien, veraltete Softwareversionen. Es zielt nicht persönlich auf Sie. Es durchsucht alles, was es offen vorfindet.
Es hilft sehr bei Angriffen mit hoher Rate, misst aber die Rate und nicht die Absicht. Ein Scanner, der langsam und unterhalb des Limits vorgeht, wird nicht begrenzt. Die Verhaltensanalyse schließt diese Lücke.
Bei jedem automatischen System ist das immer möglich. Deshalb beruht die Entscheidung auf einem Muster aus vielen Anfragen und nicht auf einer einzelnen, bekannte Adressen werden ausdrücklich ausgenommen, und jede Blockierung lässt sich rückgängig machen.
Quellen: bösartiger Scanner
Zuletzt aktualisiert: