Eigene Datenbank pro Kunde: Nutzen und Preis
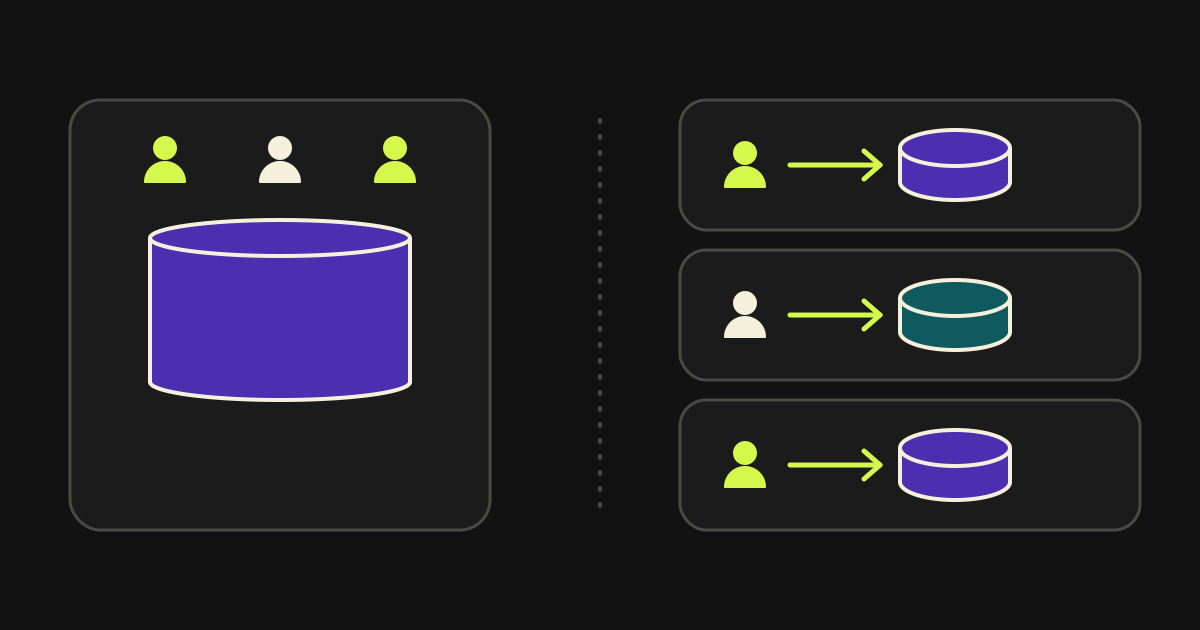
Eine eigene Datenbank pro Kunde liefert Ihnen eine Datenisolation, die sich einem Kunden und einem Prüfer leicht erklären lässt, und stellt Ihnen dafür Kosten bei Migrationen, Backups und Analytics in Rechnung. Ich habe sie gewählt und betrieben, auf einer Gesundheitsplattform in den USA.
Auf einen Blick: Datenbank pro Kunde
- Auf einer Gesundheitsplattform in den USA hatte jeder Kunde seine eigene Datenbank
- Im Silo-Modell hat jeder Tenant seinen eigenen Speicher ohne gemeinsame Daten
- Die Partitionierung der Daten garantiert für sich allein keine Isolation
- Migrationen müssen auf jeder Datenbank laufen, und das Ergebnis ist pro Datenbank zu prüfen
- Analytics über viele Datenbanken brauchen einen eigenen Analyseraum
Was bedeutet „Datenbank pro Kunde“, und wo steht sie unter den Optionen?
In Multi-Tenant-SaaS können die Daten der Kunden (Tenants) in gemeinsamen Tabellen mit einer Tenant-Spalte liegen, auf Schemas derselben Datenbank verteilt werden oder jeweils eine ganze Datenbank bekommen. Die dritte Option heißt Silo: Jeder Kunde hat seinen eigenen Speicher, ohne gemeinsame Daten.
AWS beschreibt die Unterscheidung als Silo und Pool. Im Silo gibt es für jeden Tenant eine eigene Speicherstruktur, und die Daten vermischen sich nicht. Im Pool liegen die Daten zusammen und werden über eine Tenant-Kennung getrennt. Dazwischen gibt es eine Lösung mit gemeinsamer Datenbank und einem eigenen Schema pro Kunde.
Die Gesundheitsplattform, die ich entworfen habe, lag ganz am Silo-Ende des Spektrums. Es war ein SaaS für Qualität und Compliance, mit Modulen für Analytics, Standards, Richtlinienverwaltung, einen Dateitresor und Bestände. Jeder Kunde hatte seine eigene Datenbank.
Vorab aber eine Klarstellung, die viele durcheinanderbringt. Partitionierung der Daten und Isolation sind nicht dasselbe. AWS betont es: Dass Sie die Daten getrennt haben, heißt nicht, dass ein Tenant nicht an die Daten des anderen kommt. Die Isolation muss gesondert durchgesetzt werden, mit Berechtigungen, Identitäten und Kontrollen.
Was gewinnen Sie mit einer eigenen Datenbank pro Kunde?
Sie gewinnen drei Dinge: eine Isolation, die nicht von einem korrekten WHERE in jeder Abfrage abhängt, die Möglichkeit, mit einem Kunden etwas zu tun, was mit allen zusammen nicht geht, und eine einfache Antwort, wenn ein Kunde fragt: „Wo sind meine Daten?“.
Die Isolation ist der Hauptpunkt. In einer gemeinsamen Tabelle genügt ein vergessener Tenant-Filter, damit ein Kunde die Daten eines anderen sieht. In einer eigenen Datenbank liefert derselbe Fehler im Code nichts oder scheitert, weil die Verbindung des Kunden die Daten des anderen gar nicht erreicht. Im Gesundheitsbereich, wo ein Datenleck ernste Folgen hat, ist das ein wesentlicher Vorteil.
Der zweite Punkt ist die Flexibilität pro Kunde. Sie können die Datenbank eines Kunden auf einen früheren Zeitpunkt zurücksetzen, ohne die anderen anzufassen. Sie können sie verschieben, vergrößern oder löschen, wenn der Kunde geht. Ein Kunde mit hoher Last beeinträchtigt die übrigen nicht, weil sie sich keinen gemeinsamen Raum teilen. Was AWS als Noisy Neighbor bezeichnet, wird eingedämmt.
Der dritte Punkt ist die Compliance. Fragt der Kunde oder der Prüfer, wie die Daten getrennt sind, ist die Antwort „jeder Kunde hat seine eigene Datenbank“ kurz und überprüfbar. Im Pool müssen Sie jeden Filtermechanismus erklären und belegen.
Was zahlen Sie bei den Migrationen?
Bei den Migrationen zahlen Sie dafür, dass jede Schemaänderung auf jeder Datenbank laufen muss und die Datenbanken sich in unterschiedlichem Zustand befinden können. Bei hundert Kunden haben Sie nicht eine Migration, sondern hundert, und jede kann einzeln gelingen oder scheitern.
Das erste Problem ist die Konsistenz. Ist die Migration auf neunundneunzig Datenbanken gelungen und auf einer gescheitert, muss der Anwendungscode mit beiden Schemas arbeiten, bis die Ausnahme behoben ist. Das beeinflusst, wie Sie Änderungen schreiben: erst hinzufügen, dann verschieben, zuletzt entfernen, und nie etwas umschreiben, während die alte Version noch darauf läuft.
Das zweite ist die Beobachtung. Sie brauchen eine Stelle, die zeigt, auf welchem Schemastand jede Datenbank ist. Ohne sie wissen Sie nicht, welcher Kunde zurückgeblieben ist.
Das dritte ist die Zeit. Eine Migration, die auf einer kleinen Datenbank Sekunden dauert, kann auf einer großen lange laufen und Tabellen sperren. Sie testen immer zuerst auf einer Datenbank, die den größten ähnelt.
Eine praktische Regel für Migrationen über viele Datenbanken
Jede Migration muss gefahrlos zweimal laufen können und mit der vorherigen Version des Codes kompatibel sein. So können Sie sie auf einer gescheiterten Datenbank erneut ausführen, ohne fürchten zu müssen, die erfolgreichen zu beschädigen.
Was ändert sich bei den Backups?
Bei den Backups ändert die eigene Datenbank pro Kunde die Einheit: Statt einer großen Kopie haben Sie viele kleine, und jede lässt sich unabhängig wiederherstellen. Der Gewinn ist die gezielte Wiederherstellung. Der Preis ist, dass Sie bestätigen müssen, dass jede Kopie existiert und funktioniert.
Die Wiederherstellung eines einzelnen Kunden ist der große Vorteil. Löscht ein Kunde versehentlich Daten, stellen Sie nur seine Datenbank wieder her, ohne alle anderen zurückzudrehen. Im Pool ist das viel schwieriger, und am Ende erzeugen Sie Daten von Hand neu.
Der Preis ist die Überwachung. Bei vielen Datenbanken fällt eine Kopie, die nicht erstellt wurde, nicht von selbst auf. In der Infrastruktur, die ich auf AWS aufgebaut habe, war AWS Backup der zentrale Mechanismus für die Kopien und CloudWatch die tägliche Überwachung. Entscheidend ist, dass eine Lücke früh sichtbar wird und nicht erst in dem Moment, in dem Sie die Kopie brauchen.
| Thema | Datenbank pro Kunde | Gemeinsame Datenbank |
|---|---|---|
| Wiederherstellung eines Kunden | Unabhängig, mit seiner Datenbank | Schwierig, nur seine eigenen Zeilen müssen extrahiert werden |
| Auswirkung hoher Last | Auf einen Kunden begrenzt | Auf alle verteilt |
| Migrationen | Eine pro Datenbank, mit eigenem Scheitern | Eine für alle |
| Zu überwachende Kopien | Eine pro Kunde | Eine insgesamt |
| Analytics über alle Kunden | Braucht einen eigenen Analyseraum | Eine Abfrage |
Eine Kopie, die nicht getestet wurde, ist keine Garantie. Deshalb muss die Wiederherstellung regelmäßig getestet werden, in einer getrennten Umgebung, mit einer echten Kopie eines Kunden und nicht mit einer Stichprobe. Der Test beantwortet zwei Fragen: ob sich die Kopie öffnen lässt und wie lange die Wiederherstellung dauert. Die Antwort auf die zweite werden Sie dem Kunden nennen, wenn es soweit ist, und Sie sollten sie besser vorher kennen. Bei vielen Datenbanken läuft der Test an einer wechselnden Stichprobe von Kunden, sodass über einen Zeitraum alle geprüft worden sind.
Wie machen Sie Analytics über hundert Datenbanken?
Über hundert Datenbanken schreiben Sie keine Abfrage, die sie alle live liest. Sie kopieren die Daten, die für Auswertungen nötig sind, in einen eigenen Analyseraum, mit einheitlichem Schema und Tenant-Kennung, und die Abfragen laufen dort, nicht auf den Produktionsdatenbanken. So belasten die Auswertungen nicht die Leistung der Anwendung.
Das sind die Kosten, die Teams unterschätzen. Die erste Abfrage nach dem Muster „Wie viele Nutzer haben sich diesen Monat insgesamt angemeldet?“ hat keine leichte Antwort. Dieselbe Abfrage hundertmal auszuführen und die Ergebnisse zusammenzuführen ist langsam, fragil und belastet die Kundendatenbanken.
Die Lösung hat zwei Teile. Zuerst legen Sie fest, welche Daten zur Auswertung abfließen dürfen und in welcher Form. Im Gesundheitsbereich ist das keine technische Kleinigkeit, sondern eine Compliance-Entscheidung, und sie fällt, bevor die erste Codezeile geschrieben wird. Danach bauen Sie den Fluss, der sie überträgt, so, dass er ein Scheitern und eine Wiederholung aushält.
Für die Analytics innerhalb der Plattform selbst, also das, was der Kunde über sich selbst sieht, gibt es das Problem nicht: Sie werden aus seiner eigenen Datenbank gelesen. Das Problem entsteht nur, wenn Sie alle zusammen sehen wollen, etwa für das Produkt oder für das Team, das es betreibt.
Wann lohnt sich die eigene Datenbank pro Kunde und wann nicht?
Sie lohnt sich, wenn Isolation eine Anforderung Ihres Bereichs ist, wie im Gesundheitswesen, wenn die Kunden wenige und groß sind und wenn jeder Kunde jahrelang bestehen bleibt. Sie lohnt sich nicht, wenn Sie Tausende kleine Kunden mit minimalen Daten haben. Dort rechtfertigen sich die Kosten pro Kunde nicht.
AWS weist darauf hin, dass viele Produkte in einem hybriden Modell landen: eigene Infrastruktur für die großen oder anspruchsvollen Kunden und gemeinsame für die übrigen. Das ist keine Niederlage der reinen Architektur, sondern der übliche Weg.
Mein eigenes Urteil aus der Erfahrung: Wenn Ihr Bereich einen Nachweis der Trennung verlangt, starten Sie mit Silo und zahlen Sie die Zusatzkosten früh, mit automatisierten Migrationen und Backups ab dem ersten Tag. Das schlimmste Szenario ist, mit Pool zu starten und die Datenbank aufspalten zu müssen, wenn schon Kunden in der Produktion sind.
Wenn Sie eine Plattform mit ähnlichen Anforderungen planen, sprechen wir darüber. Die Infrastruktur, auf der die Plattform lief, und eines der Abwehrsysteme, die sie schützten, beschreibt der Artikel über das Blockieren von Scannern anhand ihres Verhaltens. Meinen gesamten Weg finden Sie auf der Startseite.
Schritte für Ihre Entscheidung:
- Schreiben Sie auf, was Ihr Bereich an Datentrennung verlangt: Gesetz, Verträge, Kunden, die nachfragen werden.
- Schätzen Sie, wie viele Kunden es in drei Jahren sein werden und wie groß sie sind.
- Legen Sie fest, wie die Migrationen auf allen Datenbanken laufen und wie Sie den Stand jeder einzelnen sehen.
- Legen Sie fest, wie die Backups pro Kunde erstellt und geprüft werden.
- Entwerfen Sie den Analyseraum, bevor Sie ihn brauchen.
Häufige Fragen: Datenbank pro Kunde
Die Trennung lässt sich leichter belegen, weil ein falscher Filter im Code nicht genügt, damit ein Kunde an die Daten eines anderen kommt. Sie ersetzt aber nicht Berechtigungen und Zugriffskontrollen: Die Isolation muss unabhängig von der Partitionierung durchgesetzt werden.
Meistens ja, bei der Infrastruktur und beim Betriebsaufwand. AWS beschreibt das Silo als das Modell mit der stärksten Trennung und dementsprechend mit höheren Kosten. Die Kosten sind dem Wert der Isolation für Ihren Bereich gegenüberzustellen.
Mit einem automatisierten Verfahren, das sie auf jeder Datenbank anwendet, das Ergebnis pro Datenbank festhält und eine Wiederholung nur dort erlaubt, wo es scheiterte. Jede Migration wird so geschrieben, dass sie bei einem zweiten Lauf gefahrlos ist und mit der vorherigen Version des Codes kompatibel bleibt.
Sie können, aber es ist teuer. Der Wechsel von einer gemeinsamen Datenbank zu eigenen Datenbanken, mit Kunden in der Produktion, ist ein großes Vorhaben. Deshalb verdient die Wahl von Anfang an Überlegung, auf Grundlage der Anforderungen Ihres Bereichs.
Sie müssen nicht alle auf einmal umziehen. Beginnen Sie mit dem Kunden mit der höchsten Isolationsanforderung, bauen Sie das Anlegeverfahren und die Migrationen an ihm auf und ziehen Sie die übrigen schrittweise nach. So testen Sie die Betriebskosten im kleinen Maßstab, bevor Sie sich festlegen, und behalten die Möglichkeit, beim hybriden Modell zu bleiben, das AWS beschreibt.
Quellen: Datenbank pro Kunde
Zuletzt aktualisiert: